ChatGPTなどの生成AIが、存在しない論文の書誌情報を正確な形式で出力したり、実在しない法律条文を引用したりする現象が報告されています。
これを「AIハルシネーション」と呼び、モデルが事実と異なる情報を確信を持って生成してしまう特性を指します。
この現象には、次のような特徴があります。
- 誤情報でも文体・形式が正確に見えるため、一見して判別が難しい
- テキスト生成の仕組み上、原理的にゼロにはできない構造的な問題
- 業務・学術・法律など高精度が求められる場面でのリスクが特に高い
生成AIの出力をそのまま事実として扱うことは、現時点では推奨されません。
利用目的に応じた検証プロセスの設計が必要です。
この記事では、AIハルシネーションの定義・発生原因・具体的な事例・対策・信頼性の見極め方を順に解説します。
AIハルシネーションとは何か
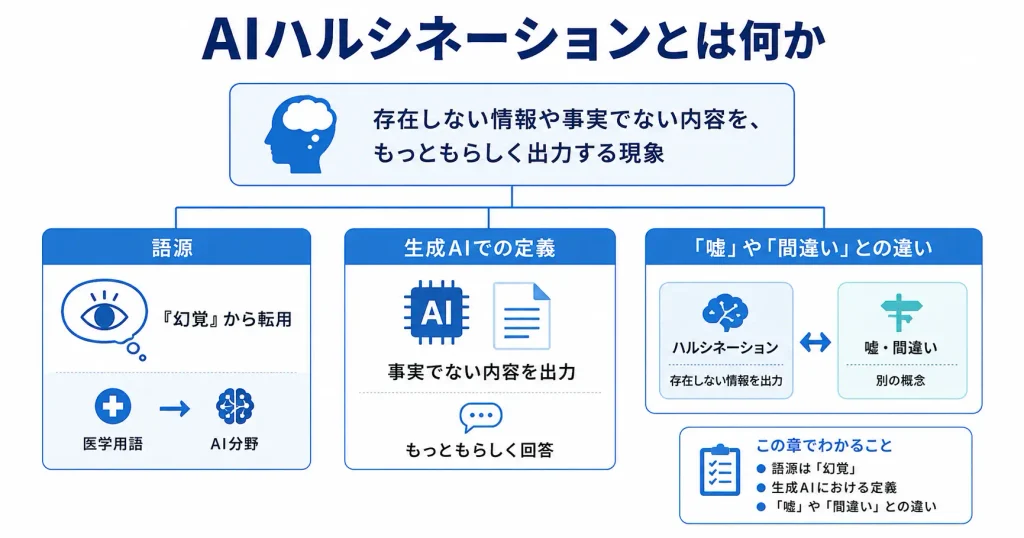
これがAIハルシネーションと呼ばれる現象です。
このH2では、以下の3点を整理します。
- 「ハルシネーション」という言葉がAI分野でどのように使われるようになったか
- 生成AIにおけるハルシネーションの正確な定義
- 単なる「嘘」や「間違い」とどう違うのか
AIを日常的に使う人ほど、この概念を正確に理解しておくことが重要です。
誤った情報をそのまま使ってしまうリスクを避けるためにも、まず「何が起きているのか」を把握することが出発点になります。
語源は「幻覚」——医学用語からAIへの転用
AI分野では、この医学的な意味合いを借りて、モデルが実在しない情報を「あるかのように」出力する現象に転用されました。
この転用が広まった背景には、大規模言語モデル(LLM)の研究が急速に進んだ2020年代前半があります。
研究者たちがモデルの出力を評価する過程で、「現実には存在しないが、モデルが確信を持って生成してしまう情報」を表現する言葉として、hallucination という用語が定着していきました。
医学的な幻覚と共通しているのは、「本人(この場合はモデル)にとっては本物のように感じられる」という点です。
AIは出力に迷いを見せず、誤った情報であっても流暢な文章で提示します。
この「自信のある誤り」という性質が、単純なエラーとは異なる問題として注目されるようになりました。
生成AIにおけるハルシネーションの定義
生成AIにおけるハルシネーションとは、モデルが事実に基づかない情報を、あたかも正確な情報であるかのように生成する現象です。出力が流暢で整合性があるように見えても、その内容が現実と乖離している状態を指します。
具体的には、次のようなケースが該当します。
- 実在しない書籍・論文・人物を引用する
- 実際には起きていない出来事を詳細に語る
- 正しい事実と誤った事実を混在させた文章を生成する
たとえば、「〇〇大学の△△教授が2021年に発表した研究によると……」という形で出典付きの文章を生成しても、その教授名も論文タイトルも実在しない、というケースは実際の利用場面で報告されています。
文章として整っているため、読んだだけでは誤りに気づきにくい点が特徴です。
この現象が厄介な理由は、出力の「見た目の品質」と「内容の正確性」が一致しない点にあります。
文法的に正しく、読みやすく、論理的に聞こえる文章であっても、その中身が誤りである可能性があります。
発生頻度はタスクの種類やモデルによって大きく異なりますが、「まれにしか起きない」と楽観視するより、「起きる可能性を前提に使う」という姿勢が現時点では適切とされることが多いです。
生成AIは「次に来る言葉として確率的に最もそれらしいもの」を選ぶ仕組みで動いています。
そのため、「正しい情報」を選ぶのではなく、「正しそうに見える情報」を生成することが一定の頻度で起こります。
この構造的な特性こそが、ハルシネーションの根本にあります。
「嘘」や「間違い」との違い
ハルシネーションは「嘘」でも「単純な誤り」でもありません。
この区別を理解することが、AIとの適切な付き合い方を考えるうえで重要です。
「嘘」は意図的に事実と異なる情報を伝える行為ですが、AIには意図がありません。
モデルは「正確な情報を伝えようとして失敗している」のではなく、そもそも「正確さを判断する仕組みを持たずに出力している」という点が根本的に異なります。
「単純な誤り」との違いも明確で、計算ミスや入力ミスは正しい情報を処理しようとした結果として生じますが、ハルシネーションは「存在しない情報を生成する」という、より構造的な問題です。
- 嘘:意図的に事実と異なる情報を伝える(AIには意図がない)
- 単純な誤り:正しい情報を扱う過程でのミス(ハルシネーションは情報そのものが架空)
- ハルシネーション:確率的な生成プロセスの結果として、実在しない情報が出力される現象
この区別が重要なのは、対策の方向性が変わるからです。
嘘であれば「意図の排除」が対策になりますが、ハルシネーションは構造的な問題であるため、異なるアプローチが必要になります。
具体的には、固有名詞・数値・出典などの重要な情報は別の信頼できるソースで確認する、という習慣が基本的な対処として挙げられることが多いです。
ハルシネーションの定義と語源を理解したところで、次に気になるのは「なぜこの現象が起きるのか」という原因です。
次のセクションでは、AIハルシネーションが発生するメカニズムを、モデルの仕組みと学習データの観点から解説します。
AIハルシネーションが起きる原因
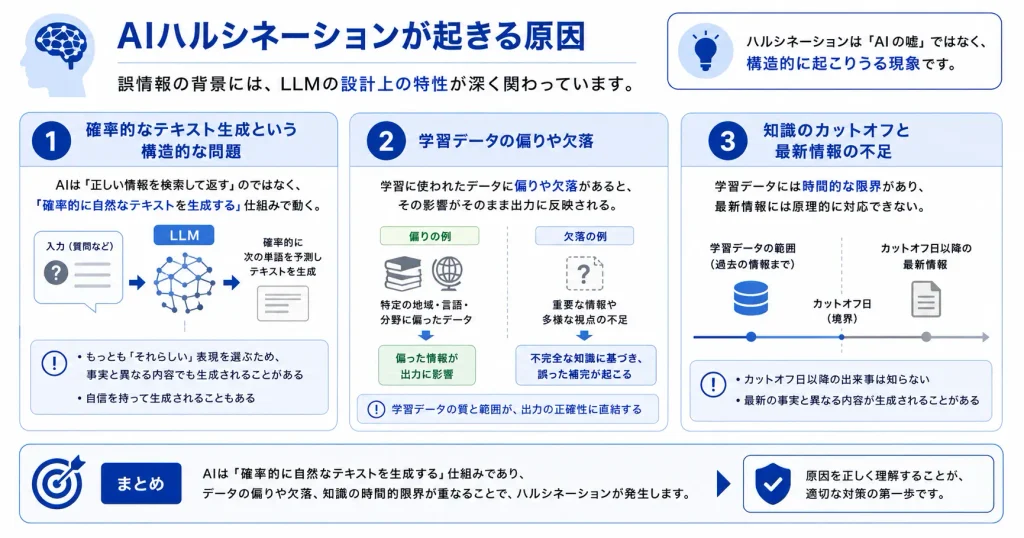
AIが誤情報を生成してしまう背景には、大規模言語モデル(LLM)の設計上の特性が深く関わっています。
- AIは「正しい情報を検索して返す」のではなく、「確率的に自然なテキストを生成する」仕組みで動いている
- 学習に使われたデータに偏りや欠落があると、その影響がそのまま出力に反映される
- 学習データには時間的な限界があり、最新情報には原理的に対応できない
この3点を押さえるだけで、ハルシネーションを「AIの嘘」ではなく「構造的に起こりうる現象」として正しく理解できます。
以下では、それぞれの原因を順に解説します。
確率的なテキスト生成という構造的な問題
AIは「次に来る単語として最も確率が高いもの」を選び続けることで文章を生成しています。
これはAIが事実を確認しながら話しているのではなく、統計的なパターンに従って文字列を組み立てているということを意味します。
この仕組みそのものが、ハルシネーションの根本的な原因です。
大規模言語モデルは、膨大なテキストデータから「この文脈ではこの言葉が続きやすい」というパターンを学習します。
そのため、文章として自然に聞こえる出力を生成することには長けていますが、その内容が事実かどうかを内部で検証する機能は持っていません。
たとえば「〇〇の論文の著者は誰ですか」と質問したとき、AIは「論文には著者名がある」という文脈パターンをもとに、それらしい人名を生成します。
その名前が実在する著者かどうかは、AIにとって判断の対象ではないのです。
- 文章の流暢さと情報の正確さは、AIの中では別の問題として扱われている
- 「もっともらしい文章」と「正しい情報」は必ずしも一致しない
- AIが自信ありげに答えていても、それは確率的な出力の結果に過ぎない
この構造的な性質を理解しておくと、AIの出力を「そのまま信じる」リスクを自然と意識できるようになります。
なお、ハルシネーションはあらゆる質問で均等に発生するわけではなく、事実確認が難しい質問・情報量が少ない分野・複数の条件が絡む質問などで起きやすい傾向があります。
逆に、広く普及している一般的な知識を問う場合は比較的安定した出力が得られることが多いとされています。
学習データの偏りや欠落
AIが学習するデータの質と量が、出力の信頼性を大きく左右します。
学習データに偏りや欠落がある場合、その影響はそのまま生成される情報の歪みとして現れます。
学習データは多ければよいというわけではなく、どのような情報が多く含まれているかが重要です。
インターネット上のテキストを大量に学習した場合、そこには正確な情報だけでなく、誤情報・偏った意見・古い情報・信頼性の低いサイトのコンテンツも混在しています。
AIはそれらを区別せずに学習するため、誤情報のパターンも同時に取り込んでしまいます。
また、ある分野の情報がデータ上に少ない場合、AIはその分野についての知識が薄いまま学習を終えます。
そうした領域で質問されたとき、AIは「知らない」と答えるのではなく、関連する断片的な情報を組み合わせて、それらしい回答を生成しようとします。
これは「回答を完成させること」を優先するよう訓練された結果として生じる設計上の副作用であり、ハルシネーションとして表面化するケースは少なくありません。
- 学習データに含まれる誤情報が、そのまま出力に反映されることがある
- 特定の分野や言語・地域に関する情報が少ないと、不正確な推測が増える
- AIは「わからない」と判断するよりも、何かしら答えようとする傾向がある
知識のカットオフと最新情報の不足
AIの学習データには「ここまでの情報しか含まれていない」という時間的な区切りがあります。
これをカットオフ(知識の打ち切り日)と呼びます。
カットオフ以降に起きた出来事や更新された情報は、AIの知識として存在しません。
たとえば、あるAIのカットオフが2023年初頭であれば、それ以降に改正された法律・交代した企業の代表者・新たに発表された研究結果などは、そのAIの知識には含まれていません。
にもかかわらず、AIは質問に対して何らかの回答を生成しようとするため、古い情報をもとにした回答や、存在しない情報を補完した回答が出力されることがあります。
また、カットオフ直前の期間は、その時点の情報がインターネット上にまだ十分に蓄積されていないため、学習データに含まれる量が少なくなりやすく、出力の精度が下がりやすいという傾向も指摘されています。
- カットオフ以降の情報はAIの知識に含まれていない
- 時事情報・法改正・人事変更など、変化の速い情報は特に注意が必要
- カットオフを把握せずに使うと、古い情報を最新のものとして受け取るリスクがある
AIを利用する際には、使用しているモデルのカットオフがいつ頃なのかを事前に確認しておくことが、情報の信頼性を判断するうえで有効な手がかりになります。
多くのAIサービスでは、公式サイトや設定画面でカットオフの時期を確認できる場合があります。
原因の構造がわかったところで、「ではAIの出力をどこまで信頼してよいのか」という疑問が浮かぶのは自然なことです。
次のセクションでは、現実に報告されているハルシネーションの事例を取り上げ、どのような状況でリスクが高まるかを確認します。
AIハルシネーションの具体的な事例
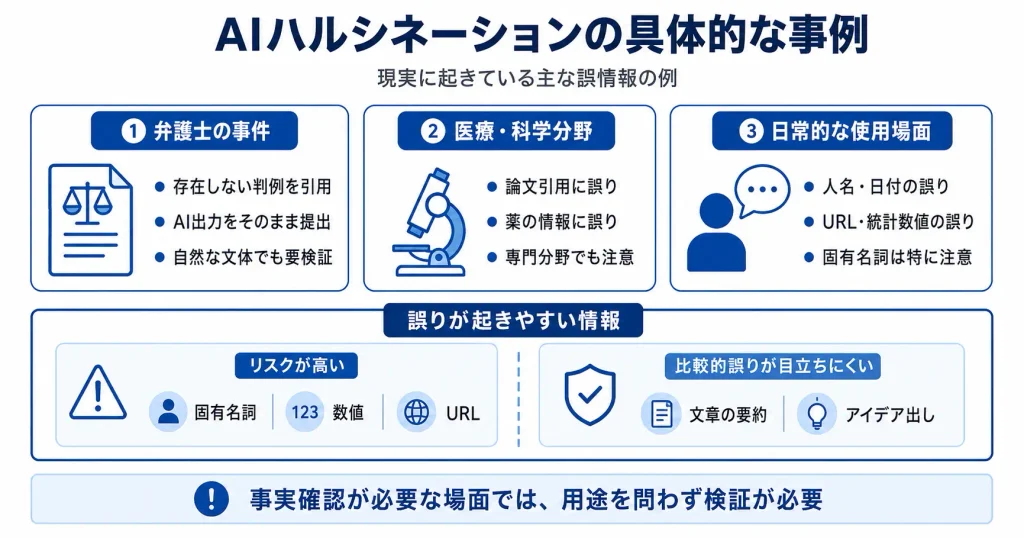
AIが誤情報を生成する現象は、理論上の話ではなく、すでに現実の場面で多数の問題を引き起こしています。
- 弁護士がAIの出力を信じ、実在しない判例を裁判所に提出した事件が報告されています
- 医療・科学分野では、論文の引用や薬の情報に誤りが混入するリスクが指摘されています
- 日常的な使用場面でも、人名・日付・URL・統計数値などの誤りが頻繁に発生しています
ハルシネーションは「たまに起きる小さなミス」ではなく、専門家でさえ見落とすほど自然な文体で出力される点が問題です。
具体的な事例を知ることで、どの場面でどんな誤りが起きやすいかの感覚を養えます。
存在しない判例を引用した弁護士の事件
これはハルシネーションが「専門家の判断」を誤らせるほどの説得力を持つことを示す、最も広く知られた事例のひとつです。
この事件では、アメリカの弁護士がChatGPTを使って訴訟の準備書面を作成しました。
AIは複数の判例を引用した文書を生成しましたが、その中に実在しない判例が含まれていました。
弁護士はAIの出力を十分に検証せず、そのまま裁判所に提出したため、裁判官から厳しく指摘を受ける結果となりました。
- AIは実在する判例と架空の判例を、まったく同じ文体・形式で出力する
- 引用の形式(事件番号・裁判所名・年号など)が整っているため、一見して偽物と気づきにくい
- 専門知識のある人物でも、AIへの信頼から検証を省略してしまうことがある
法律・会計・医療などの専門領域では、情報の正確性が直接的なリスクに直結します。
AIを業務に活用する場合は、必ず一次情報(公式データベースや原典)での確認を行うことが前提となります。
医療・科学分野での誤情報生成
医療・科学分野のハルシネーションは、誤りが命に関わるリスクを持つため、特に注意が必要です。
AIは専門用語を正確に使いながら、内容が誤った文章を生成することがあります。
具体的には、次のような誤りが報告されています。
- 実在しない論文の著者名・掲載誌・DOI番号が生成される
- 薬の用量・禁忌・副作用に関する情報が誤って出力される
- 既存の研究結果を誤って要約し、原典とは逆の結論が示される
科学分野では、研究者がAIを用いて文献調査を行う場面が増えています。
しかしAIは「それらしい論文情報」を生成する能力が高く、実在しない論文のタイトルや著者名を自信を持って出力するケースが確認されています。
PubMedなどの公式データベースで検索しても該当する論文が見つからない、というトラブルは一定の頻度で報告されています。
医療情報においても同様で、一般ユーザーが症状や薬について調べる際に誤った情報を受け取るリスクがあります。
AIの出力を医療判断の根拠にすることは、現時点では推奨されていません。
技術的な改善が進んでいる分野ではありますが、医療・科学に関する情報は、専門家や公式機関の情報源を参照することが求められます。
日常的な使用場面での典型的な誤り
被害が小さく見えるため見落とされがちですが、誤情報が複数箇所に混入した場合、文書全体の信頼性を損なう結果につながります。
日常場面で起きやすい典型的な誤りは以下のとおりです。
- 人物の経歴・発言・著作に関する誤情報(存在しない著書の引用など)
- 企業情報・サービス内容・料金の誤り
- URLやメールアドレスが架空のものとして生成される
- 統計数値や調査結果が実際とは異なる数値で出力される
- 歴史的な出来事の日付・場所・登場人物が混同される
特に注意が必要なのは、AIが「知らない」と言わずに回答する点です。
これはAIが確率的に「最もらしい語のつながり」を生成する仕組みで動いているためで、情報の正誤を内部で判定する機能を本来的に持っていません。
そのため、情報が不確かな場合でも、自信を持った文体で回答を生成します。
日常的な使用では「軽い確認程度なら大丈夫」という感覚が生まれやすいですが、ビジネスプレゼンで誤った統計数値をそのまま使用した場合、社内での信頼に影響するといった実害につながることもあります。
SNS投稿や社外向け文書への転用も同様です。
ここまで見てきた事例は、いずれも「どんな種類の誤りが起きやすいか」という傾向を示しています。
次のセクションでは、ハルシネーションがどのようなパターンに分類されるかを整理し、誤りを見抜くための判断軸を解説します。
ハルシネーションの主なパターン
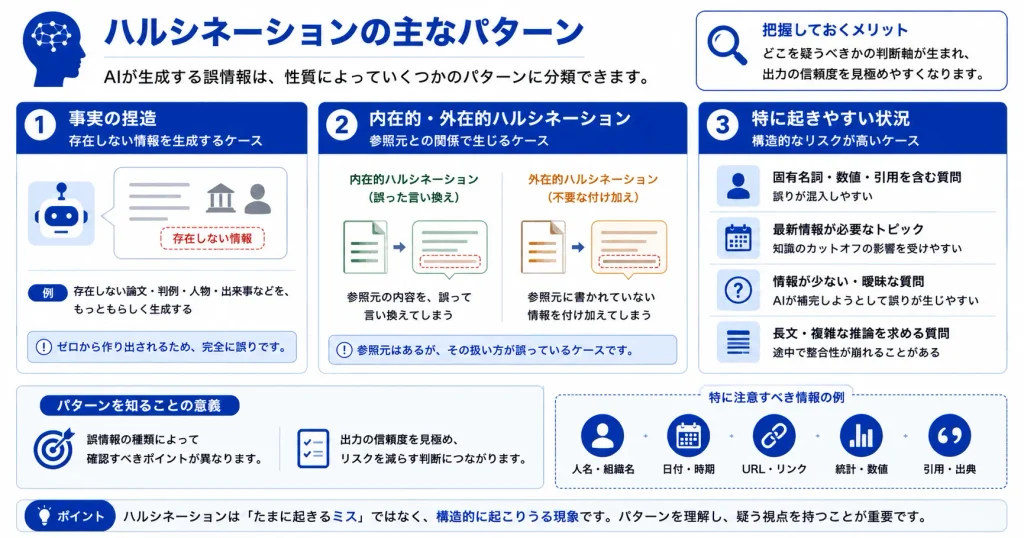
- 存在しない情報をゼロから作り出す「事実の捏造」
- 参照元の内容を誤って言い換える「内在的ハルシネーション」
- 参照元に書かれていない情報を付け加える「外在的ハルシネーション」
- 特定の状況・トピックで発生しやすい構造的なリスク
パターンを把握しておくと、AIの出力を受け取ったときに「どこを疑うべきか」の判断軸が生まれます。
誤情報の種類によって確認すべきポイントが異なるため、分類を理解しておくことはAIを使う上でのリスク感覚を整えることに役立ちます。
なお、一般的に「固有名詞・数値・引用」を含む出力はハルシネーションが混入しやすいとされています。
パターンを知ることは、出力の信頼度を見極める上でも直接役立ちます。
事実の捏造——存在しない情報を生成するケース
AIが参照元なしに、実在しない情報をあたかも事実であるかのように生成するパターンです。
確認手段がなければ見抜くことが難しく、実害につながりやすい点で注意が必要です。
具体的には、次のような形で現れます。
- 実在しない論文・書籍のタイトルや著者名を引用する
- 存在しない法律の条文番号や判例を提示する
- 架空の統計データや調査結果を数値つきで述べる
- 実在しない人物の発言や経歴を詳細に説明する
- 観光地の営業時間や料理のレシピの分量など、日常的な情報を誤って断言する
こうした捏造が厄介なのは、AIが「断言する口調で」出力する点にあります。
読者が専門知識を持っていない領域ほど、誤りに気づきにくくなります。
内在的ハルシネーションと外在的ハルシネーション
ハルシネーションは「捏造か否か」だけで分類するのではなく、参照元との関係性によって「内在的」と「外在的」の2種類に整理できます。
- 内在的ハルシネーション:参照元を要約・言い換える際に、元の意味と矛盾した内容を生成するケース
- 外在的ハルシネーション:参照元には一切記載されていない情報を付け加えて生成するケース
この2つを理解しておくと、「AIに文章を要約させたとき」や「何かを調べさせたとき」のどちらで注意が必要かが見えやすくなります。
内在的ハルシネーションのポイント
内在的ハルシネーションは、要約・翻訳・書き換えといった作業で発生しやすいパターンです。
元の文章が存在するにもかかわらず、AIがその意味を誤って解釈し、反対の主張や異なる数値に変換してしまうことがあります。
たとえば長い記事を要約させたとき、元の文章では「効果が限定的」と書かれていた内容が「効果がある」と言い換えられてしまうケースが該当します。
原文と出力を並べて比較すれば発見できる反面、出力だけを見ていると気づけないという特性があります。
外在的ハルシネーションのポイント
外在的ハルシネーションは、参照元に書かれていない情報が「補足」や「追加説明」として付け加えられるパターンです。
AIに特定のページの内容を整理させると、そのページには書かれていない「一般的な傾向」や「関連情報」が自然な流れで追加されることがあります。
特にRAG(検索拡張生成:外部の情報をAIに参照させながら回答を生成する仕組み)を用いたシステムでは、参照元に存在しない情報の混入を監視することが課題のひとつとなっています。
「これは元の情報に書かれていたことか」を意識して読むことが対処の基本です
ハルシネーションが特に起きやすい状況
ハルシネーションはあらゆる場面で起きうるものの、発生しやすい状況はある程度パターン化されています。
リスクが高い状況を把握しておくことで、出力を読む際の優先度の判断がしやすくなります。
発生しやすい状況は、主に以下のとおりです。
- 最新情報・時事的なトピックを問うとき(学習データのカットオフ以降の情報が存在しない)
- ニッチな専門領域や地域固有の情報を求めるとき(学習データが少ない)
- 長い文脈や複雑な条件を含むプロンプトを使うとき(文脈の追跡が難しくなる)
- 「必ず〜を挙げてください」のように件数を強制するとき(情報が足りなくても埋めようとする)
- 曖昧な質問に対して詳細な回答を求めるとき(推測で補完する量が増える)
特に「件数の強制」は見落とされがちなリスク要因です。
「5つ事例を挙げてください」と指示した場合、実際には3つしか実在しない事例でも、AIは残りの2つを生成しようとする傾向があります。
情報処理推進機構が公表している「AI白書」などでも、プロンプトの設計がハルシネーション発生率に影響することが指摘されています。
どのパターンに該当するかを意識するだけで、AIの出力を受け取る際の視点が変わります。
次のセクションでは、こうしたパターンを踏まえた上で、具体的にどう対策を講じるかを解説します。
AIハルシネーションへの対策
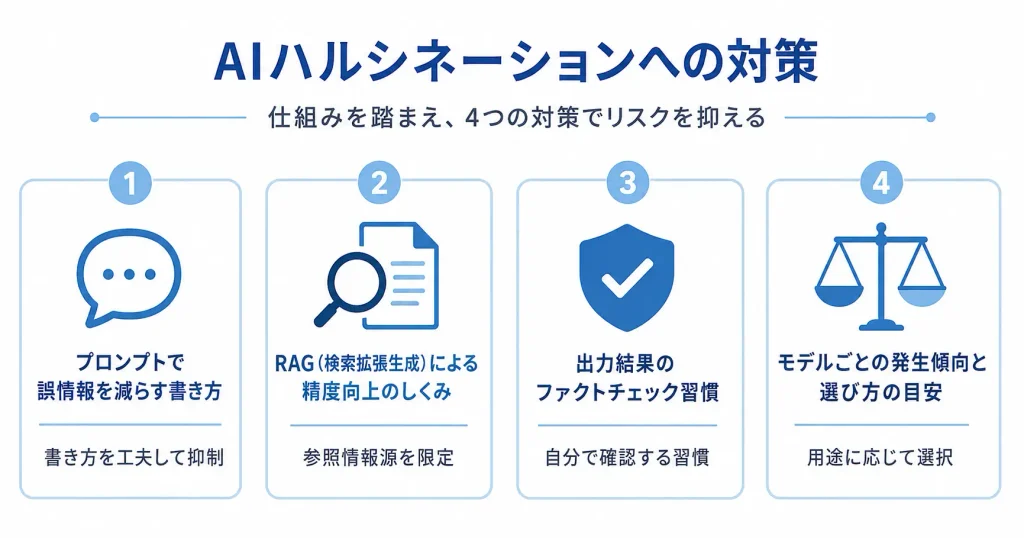
- プロンプトの書き方を工夫することで、誤情報の出力を一定程度抑制できる
- RAG(検索拡張生成)を活用すると、AIが参照できる情報源を限定できる
- 出力結果を自分でファクトチェックする習慣が、実務上の安全網になる
- モデルごとにハルシネーションの発生傾向が異なり、用途に応じた選択が重要になる
AIを日常的に使う人にとって、これらの対策を知っているかどうかで、実務上のリスクは大きく変わります。
ハルシネーションが起きる根本的な原因は、AIが「正確な情報を検索する」のではなく「もっともらしい文章を確率的に生成する」という仕組みにある点を踏まえると、なぜこれらの対策が有効なのかが理解しやすくなります。
本セクションでは、今日から実践できる4つのアプローチを順に解説します。
プロンプトで誤情報を減らす書き方
AIへの指示(プロンプト)の内容次第で、ハルシネーションの発生しやすさは変わります。
「わからない場合はわからないと答えてください」「推測を含む場合はその旨を明示してください」といった制約を明示的に加えるだけで、AIが不確かな情報を断定的に出力する機会を減らせます。
具体的に効果が期待できるプロンプトの工夫は、以下の3点です。
- 不確かな情報を断定しないよう明示的に指示する(「わからない場合はわからないと述べてください」)
- 回答の根拠や出典を示すよう求める(「どこからの情報か説明してください」)
- 質問を具体的・限定的にする(広すぎる質問はAIが推測で補いやすくなる)
特に「根拠を示すよう求める」指示は有効です。
AIが出典を明示しようとする過程で、自身の不確かさに気づき、回答を慎重にするケースがあります。
ただし、AIが「それらしい出典」を作り上げることもあるため、示された出典は必ず別途確認することが前提です。
また、質問を細かく分割して段階的に確認する「ステップバイステップ」の指示も、論理的な整合性を保たせるうえで有効とされています。
RAG(検索拡張生成)による精度向上のしくみ
RAGは、AIがテキストを生成する前に、あらかじめ指定された情報源(社内データベース・公式ドキュメント・最新ニュースなど)を検索し、その内容を参照しながら回答を生成する仕組みです。
RAGが効果的な理由は、AIが「知識を記憶から引き出す」のではなく、「提示された文書から答えを探す」という動作に切り替わる点にあります。参照できる情報源が明確に限定されるため、AIが存在しない情報を作り上げる余地が狭まります。
ハルシネーション対策として有効とされる手法のひとつであり、他のプロンプト工夫とは性質が異なります。
なお、RAGは主に企業や開発者が導入・構築するシステムであり、個人が今すぐ手軽に利用できるものではありません。
ChatGPTのようなサービスに搭載されているWeb検索機能は、RAGに近い考え方を取り入れた機能として理解すると、概念のイメージがつかみやすいでしょう。
企業での活用事例としては、社内規程や製品マニュアルをデータソースとして接続し、社員向けの問い合わせ対応に使うケースが増えています。
この場合、AIは「提供されたドキュメントの中から答えを探す」という動作になるため、ドキュメントに記載のない内容については「情報がありません」と返しやすくなります。
出力結果のファクトチェック習慣
AIの出力を受け取った後、重要な情報は必ず一次情報で確認する習慣が、実務上の最終的な安全網になります。
特に、数値・固有名詞・法律・医療・歴史的事実など、誤りが実害につながりやすい情報は、AI任せにしないことが基本です。
すべての出力を均等に確認しようとすると負担が大きくなるため、以下の優先度を目安にするとよいでしょう。
- 優先度が高い確認対象:数値・法律・医療情報・固有名詞(人名・機関名・書籍名など)など、誤りが実害に直結しやすい情報
- 次に確認したい対象:「〜と言われています」「〜によると」といった曖昧な引用や、自分の既存知識と矛盾する記述
- 比較的リスクが低い用途:文章の言い換えや要約など、事実確認よりも表現の調整が主目的の作業
AIの出力が自信満々に見えるほど、ハルシネーションを見落としやすくなります。
「文章がなめらかで断定的に書かれている」「具体的な数字が含まれている」といった特徴は、正確さの証拠ではなく、むしろ注意が必要なサインと捉えることが基本的なリテラシーです。
確認が難しいテーマについては、AIに「この情報の確認方法を教えてください」と聞いてみることも、一つの手がかりになります。
モデルごとの発生傾向と選び方の目安
AIモデルによって、ハルシネーションの発生しやすいテーマや頻度には違いがあります。
一般的に、モデルの規模が大きく、学習データが豊富なほど精度は高い傾向がありますが、それでも特定の分野(専門的な法律・医療・最新情報など)では誤りが生じやすいことが知られています。
たとえば、ChatGPT(OpenAI)やGemini(Google)のような広く使われているモデルでも、学習データのカットオフ以降の出来事については情報が不足しており、ハルシネーションが起きやすい傾向があります。
これらのモデルにWeb検索機能が追加されているのは、こうした時事情報の弱点を補うためでもあります。
同じモデルでも得意な質問タイプと苦手な質問タイプがあるため、用途ごとに出力の確認水準を変えることが現実的な対応です。
- 最新情報が必要な用途:学習データのカットオフ日時を確認し、必要に応じてWeb検索機能付きのモデルを選ぶ
- 専門的な業務への活用:そのドメインに特化したファインチューニング済みモデルや、RAG対応のシステムを検討する
- 一般的な文章生成・要約:汎用モデルでも対応できるが、出力の確認は欠かさない
各モデルの開発元が公開しているベンチマーク結果や、独立した研究機関による評価レポートも、選定の参考になります。
ただし、ベンチマーク上の数値が高くても実際の使用環境では異なる結果が出ることがあるため、自分が実際に使うタスクで試してみることが、最も実態に近い判断材料になります。
ここまで、ハルシネーションを減らすための実践的な対策を4つ紹介しました。
次のセクションでは、これらの対策を踏まえたうえで「AIの出力をどこまで信頼してよいか」という、より本質的な判断軸について解説します。
AIの出力をどこまで信頼してよいか
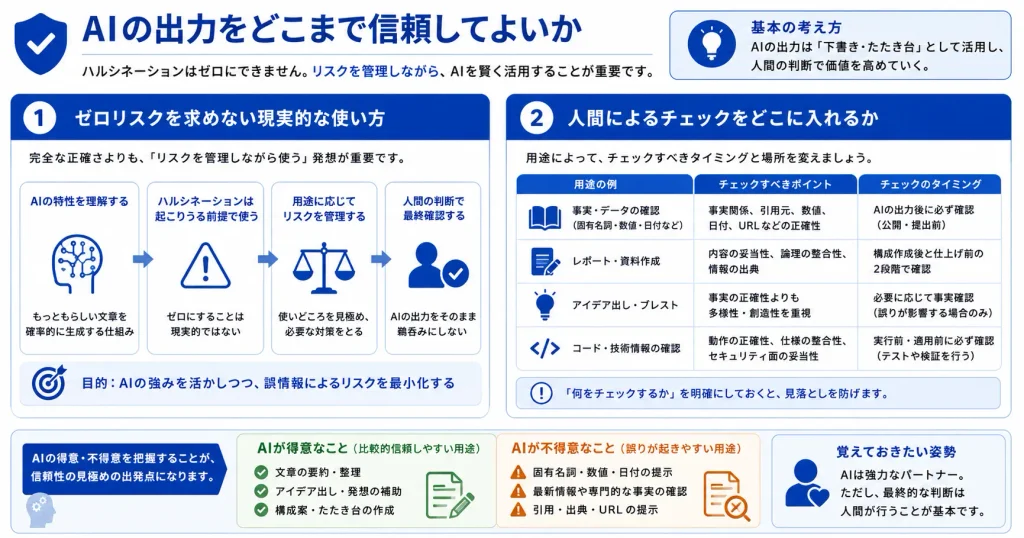
AIハルシネーションとは、AIが事実とは異なる情報を、あたかも正確であるかのように生成してしまう現象です。
このセクションでは「ではどう使えばよいか」という実践的な方針を整理します。
- ハルシネーションをゼロにすることは現実的ではなく、「リスクを管理しながら使う」姿勢が重要
- 人間によるチェックを入れるべきタイミングと場所は、用途によって異なる
- AIの得意・不得意を把握することが、信頼性の見極めの出発点になる
AIを使う上で「完全に正確な出力だけを受け取ろう」と考えると、実務での活用が難しくなります。
重要なのは、ハルシネーションが起きやすい状況を把握し、そのリスクを人間の判断で補う仕組みを作ることです。
ゼロリスクを求めない現実的な使い方
AIの出力に誤りがまったく含まれない状態を目指すのは、現時点では非現実的です。
重要なのは、「誤りが含まれる可能性がある」という前提のもとで、用途に応じた使い方を選ぶことです。
「用途に応じた」とは、「その出力が誤っていた場合に何が起きるか」を基準に使い方を判断する、ということを指します。
- 得意な作業:たたき台の作成・アイデア出し・文章の整形など、方向性の正確さより量や速度が求められる作業
- 苦手な作業:最新情報の参照・固有名詞や数値を含む事実確認・一次情報が必要な調査
この得意・不得意の区分が生まれる背景には、AIが確率的にテキストを生成する仕組みと、学習データが持つ時間的・内容的な限界があります。
最新情報に弱いのは学習データに収録されていない情報をAIが補完しようとするためであり、固有名詞に誤りが出やすいのは特定の人物・組織名が確率的な生成の対象になるためです。
この仕組みを理解しておくと、どの場面でより慎重になるべきかの判断がしやすくなります。
具体的には、AIの出力を「最終成果物」として扱うのではなく、「素材」として位置づける考え方が有効です。
たとえばレポートの構成案をAIに出してもらい、実際の数値や固有名詞は自分で調べて差し替えるという使い方がその典型です。
AIの出力を起点にしながら、事実確認は人間が担う分担を明確にすることで、作業効率と信頼性を両立できます。
また、AIに「出典を示してください」と指示する方法もありますが、AIが存在しない文献を架空に生成するケースもあります。
出典名が正確に見えても内容が正確であるとは限らないため、示された出典は必ず別途確認する習慣が必要です。
- 低リスクで使いやすい用途:ブレインストーミング・文章の言い換え・翻訳の下訳・コードの雛形生成
- 要注意の用途:法律・医療・金融に関する情報収集・固有の人物や組織に関する記述・最新のニュースや統計の参照
人間によるチェックをどこに入れるか
影響度が高い情報ほど、一次情報(公式サイト・論文・統計など)との照合を行い、複数の情報源で内容を確認するステップを加える必要があります。
影響度の判断基準として、次の問いが役立ちます。
- その情報が誤っていた場合、誰かに不利益や損害が生じるか
- 外部に公開される情報か、内部での参考利用にとどまるか
- 一次情報(公式サイト・論文・統計)で確認できる情報か
チェックを入れるタイミングのポイント
チェックは「出力を受け取った直後」ではなく、「その情報を使う直前」に行うのが効果的です。
AIの出力を一度メモとして受け取り、実際に文書や提案に組み込む段階で事実確認を行う流れにすると、確認漏れが減ります。
また、複数の情報をまとめてチェックするよりも、用途ごとに個別に確認する方が精度が上がります。
高影響度の情報の場合
医療・法律・金融・教育など、誤情報が深刻な影響を与えうる領域では、AIの出力を参考資料として使いながら、必ず専門家や公的機関の情報で裏を取る手順を設けることが求められます。
AIは「調べる手間を減らすツール」として使い、「判断の根拠」としては扱わない、という線引きが実務上の安全策になります。
チェックを省略できる条件のポイント
チェックを省略できるのは、出力の誤りが最終的な成果に影響しない場合に限ります。
判断の目安は「その出力が外部に出るか」「誰かの意思決定に使われるか」の2点を確認することです。
たとえば社内向けのアイデア一覧を作るためにAIを使う場合、個々のアイデアの正確性より網羅性や多様性が求められるため、事実確認の優先度は低くなります。
一方、その一覧を外部向け資料に転用する場合は、チェックの必要性が一気に高まります。
用途が変わればリスクも変わる、という意識を持つことが重要です。
ハルシネーションが起きやすい場面を把握し、人間のチェックを適切に組み合わせることで、AIは実務の強力な補助ツールになります。
具体的な対策ツールや手法についてさらに詳しく知りたい方は、「AI ハルシネーション 対策」をテーマにした関連記事やツール紹介も参考にしてみてください。
AIハルシネーションに関するよくある質問
AIハルシネーションについては、「どれくらい信頼していいのか」「自分の使い方に問題があるのか」といった判断に迷う方が多くいます。 このセクションでは、仕組みや発生頻度、防止策の限界など、実際に疑問として挙がりやすいポイントを整理しています。 正確な理解を持つことが、AIを安全に活用するための第一歩になります。 ご自身の疑問に近い質問から、ぜひ参考にしてみてください。
ハルシネーションと単なる間違いは何が違うのですか?
一般的な「間違い」とは、計算ミスや入力エラーのように原因が特定しやすく、修正も比較的容易なものを指します。
一方、AIハルシネーションは、事実と異なる情報を正確であるかのように生成してしまうという点に本質的な特徴があります。
つまり、AIが「わからない」と判断して止まるのではなく、もっともらしい文体や構成で誤情報を出力し続けるため、見た目では誤りと気づきにくいのです。
単純なミスであれば出力結果の不自然さで気づけることも多いですが、ハルシネーションは内容の信憑性を外見から判断しにくいという点で、より注意が必要なリスクといえます。
AIハルシネーションはどのくらいの確率で起きますか?
発生率はモデルの種類・バージョン、質問の難易度、専門性の高さなどによって変わるため、「何%で起きる」と一律に示すことは困難です。
一般的なベンチマーク評価では、タスクの内容次第で数%から数十%程度の幅があるとされており、特に事実確認が難しい専門領域や曖昧な質問ほど発生しやすい傾向があります。
一方で、プロンプトの工夫・出力の検証・RAG(検索拡張生成)などの対策を組み合わせることで、発生率を大幅に抑えることは十分に可能です。
「ハルシネーションしないでください」とプロンプトに書けば防げますか?
プロンプトに明示的な指示を加えることで、AIが慎重な回答をしやすくなる傾向はあります。
ただし、AIはその指示自体を「守れているかどうか」を自己判断する能力に限界があるため、指示だけでハルシネーションをゼロにすることは難しい状況です。
より効果的なアプローチとしては、「情報源を明示するよう求める」指示や、「わからない場合はわからないと答えるよう指示する」といったプロンプト設計が有効とされています。
これらの工夫により、AIが根拠のない情報を生成するリスクを下げやすくなります。
ハルシネーションは今後なくなりますか?
AIの性能向上とともに、ハルシネーションの発生頻度は改善されてきています。
しかし、AIが確率的に次の言葉を生成するという根本的な仕組みを持つ以上、構造上の問題として完全に排除することは困難だと考えられています。
技術の進化に頼るだけでなく、ユーザー自身のリテラシーを高めることが、ハルシネーションによるリスクを抑えるうえで重要な対策となります。
ハルシネーションが特に起きやすい質問のパターンはありますか?
特にリスクが高いのは、マイナーな人名や固有名詞を含む質問です。
知名度の低い人物や組織については、学習データが少ないためAIが情報を補完しようとし、存在しない経歴や発言を生成することがあります。
同様に、学習データの収集時期より後に起きた出来事や、最新の統計・法改正に関する質問も、AIが古い情報や架空の情報で穴埋めしやすい場面です。
また、複数の条件が絡み合う複雑な数値計算や、「〇〇は本当に存在するか」という存在確認を前提とした質問も注意が必要です。

コメント